21 de abril de 2025
El aprendizaje semisupervisado, explicado
Aprendizaje supervisado, no supervisado y semisupervisado: ¿qué es el aprendizaje semisupervisado?
Durante las últimas semanas, hemos recorrido el mundo del machine learning.
Después exploramos el aprendizaje supervisado, en el que las máquinas aprenden con datos claramente etiquetados. Luego profundizamos en el aprendizaje no supervisado, en el que los modelos descubren patrones ocultos sin ninguna etiqueta.
Hoy vamos a explorar lo que ocurre entre los dos.
Se llama aprendizaje semisupervisado. Y es una de las formas más prácticas y potentes que tienen las máquinas de aprender. También una de las más parecidas a cómo aprendemos las personas.
Este método combina la claridad de la supervisión con la libertad de explorar. Y así es precisamente como se entrenan muchos de los modelos de IA más avanzados de hoy.
Aprendizaje supervisado, no supervisado y semisupervisado
La mayoría de los sistemas de IA se basan en:
- Aprendizaje supervisado, en el que cada dato está etiquetado con mucho cuidado
- Aprendizaje no supervisado, en el que el sistema encuentra patrones sin ninguna orientación
El semisupervisado está a medio camino.
Empieza con un pequeño conjunto de ejemplos etiquetados. Los justos para orientar a la IA. Después, usa ese pequeño conjunto para enseñar al modelo a interpretar la parte más grande, que no tiene etiquetas.
Con el aprendizaje semisupervisado, el entrenamiento es más rápido porque no hace falta etiquetar cada dato.
También es más adaptable y económico.
La ventaja del aprendizaje semisupervisado
Para enseñar a un modelo de IA a reconocer imágenes, generar texto o entender el lenguaje, necesitas datos.
Pero no vale cualquier dato: tiene que estar etiquetado.
Eso significa que una persona tiene que revisar miles, incluso millones, de archivos y etiquetarlos.
Es lento, caro y casi imposible de hacer a gran escala.
Ahí entra el aprendizaje semisupervisado.
En lugar de etiquetarlo todo a mano, etiquetas una pequeña parte y dejas que el modelo aprenda de ella para etiquetar el resto.
Cómo funciona el aprendizaje semisupervisado
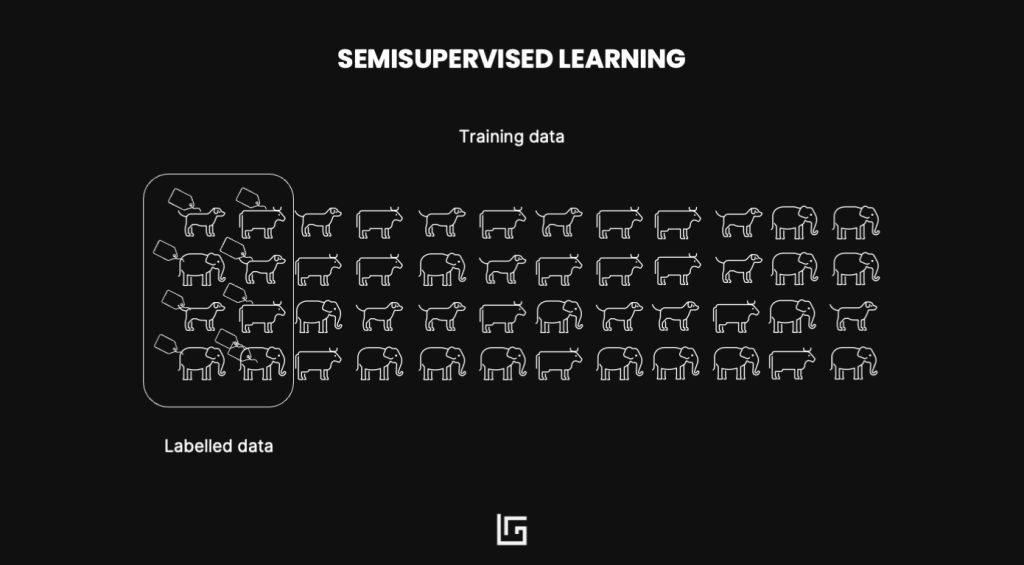
Volvamos a nuestro ejemplo de los animales. Imagina que tienes un montón de fotos de animales.
Algunas están etiquetadas. La mayoría, no.
Hay una mezcla de perros, vacas y elefantes.
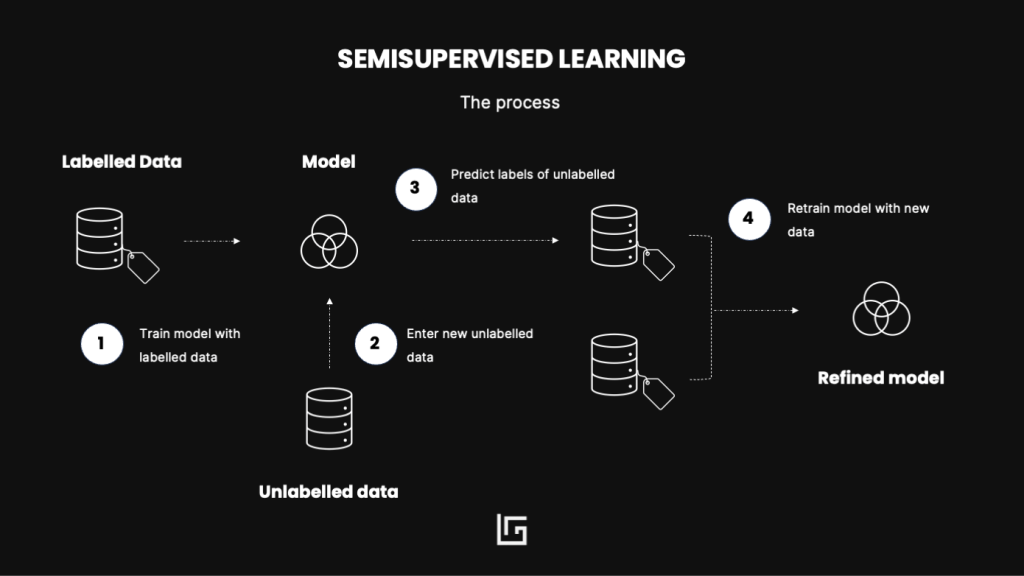
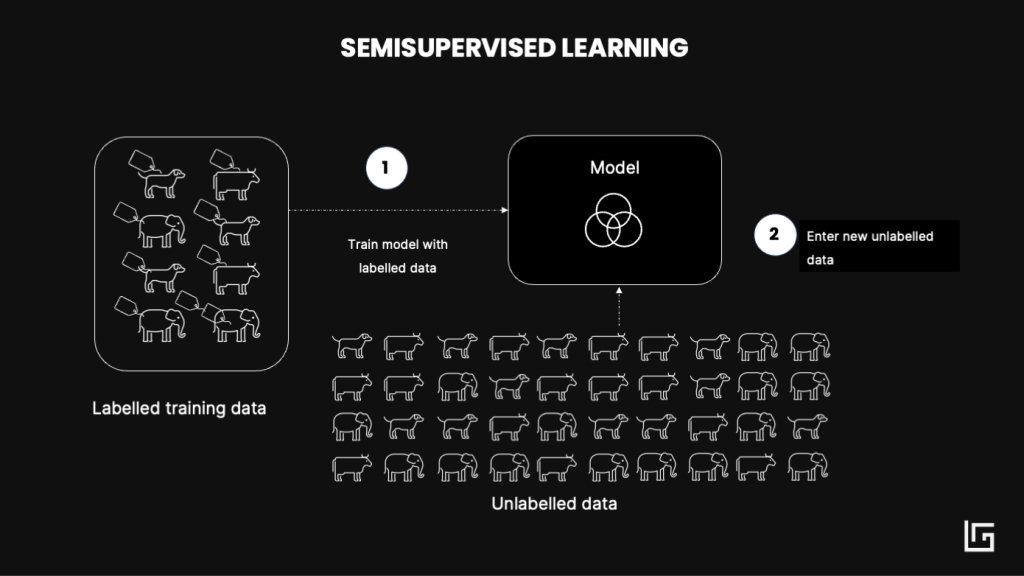
Paso 1: empieza con poco
Empiezas con unas pocas imágenes etiquetadas.
Tres perros. Tres vacas. Tres elefantes.
Con eso basta para empezar. El modelo aprende de estos ejemplos etiquetados qué hace que un perro sea un perro, qué rasgos definen a un elefante y qué distingue a una vaca del resto.
Paso 2: añade datos sin etiquetar
Ahora incorporas un conjunto de datos mucho mayor, todos sin etiquetar.
Incluye más perros, vacas y elefantes, pero ninguna etiqueta que le diga al modelo qué es cada cosa.
Con lo que ha aprendido de los datos etiquetados, el modelo empieza a hacer suposiciones.
Esto parece un perro. Eso probablemente sea una vaca. Este podría ser un elefante.
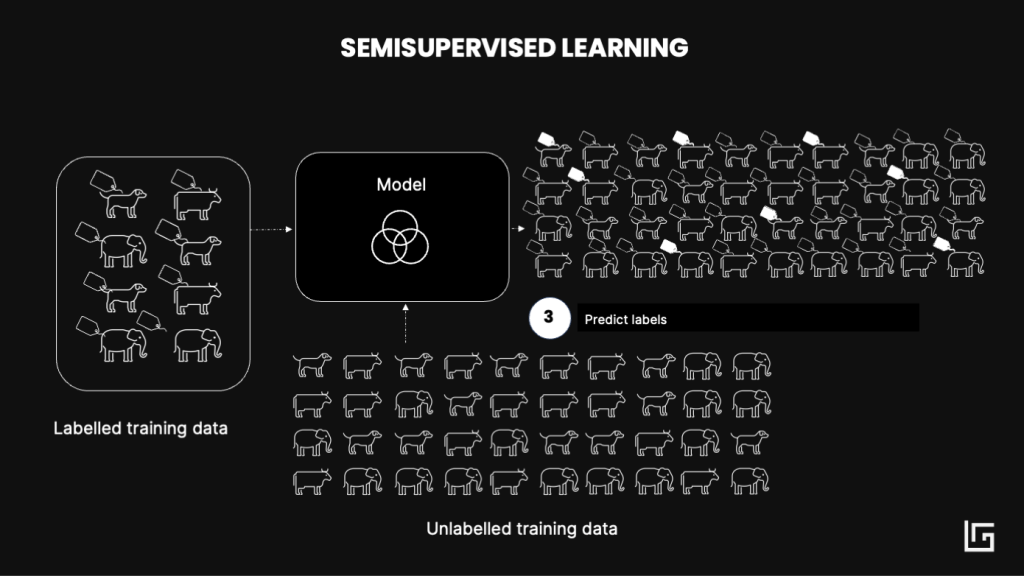
Paso 3: predice y etiqueta
El modelo etiqueta todos los datos que no tienen etiqueta según lo que sabe en ese momento.
En este punto, hace suposiciones con fundamento. No da respuestas perfectas.
No pasa nada. Se aprende probando.
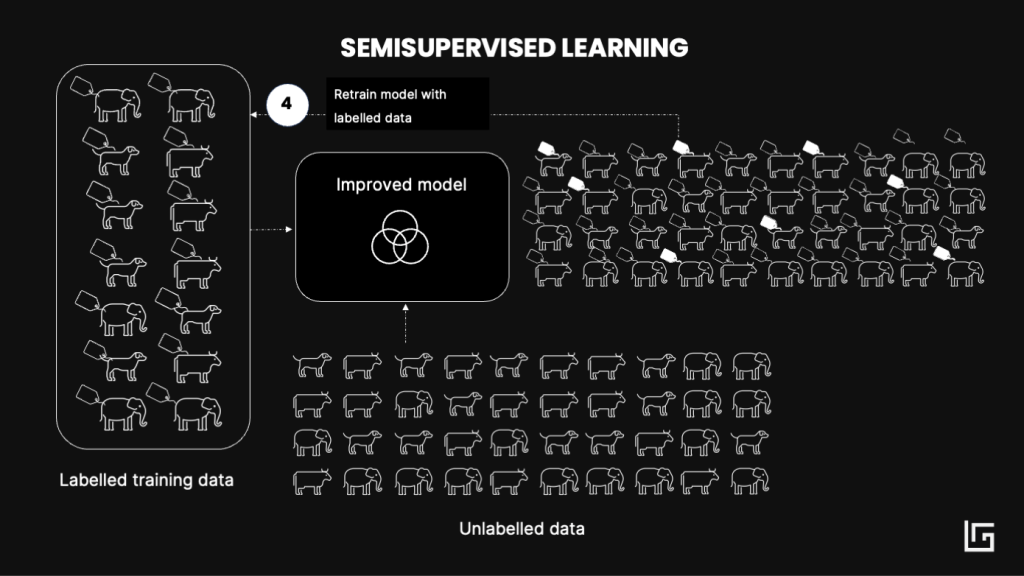
Paso 4: vuelve a entrenar con más datos
Una vez que todo está etiquetado, tanto por personas como por el propio modelo, el sistema vuelve a entrenarse.
Ahora trabaja con más datos y entiende mejor cómo clasificar lo que ve.
El resultado es un modelo de clasificación que puede clasificar animales más rápido y con mayor precisión. Y todo ello con mucha menos necesidad de etiquetar enormes cantidades de datos a mano.
Semisupervisado y autosupervisado: ¿cuál es la diferencia?
Seguramente has oído hablar del aprendizaje autosupervisado y te preguntas si tiene algo que ver con el semisupervisado.
El aprendizaje semisupervisado empieza con una pequeña cantidad de datos etiquetados y la combina con una gran cantidad de datos sin etiquetar. El modelo aprende de los ejemplos etiquetados y después intenta aplicar ese conocimiento a los que no lo están. Así va mejorando sus predicciones con el tiempo. Sigue habiendo una pequeña intervención humana al principio para orientar el proceso.
El aprendizaje autosupervisado, en cambio, no depende en absoluto de datos etiquetados. El modelo genera sus propias etiquetas a partir de los datos en bruto. Por ejemplo, puede predecir las partes que faltan en una frase o identificar qué parte de una imagen se ha movido o modificado. Este tipo de aprendizaje ha impulsado grandes avances en modelos como GPT y BERT, que disponen de enormes cantidades de datos, pero de pocos ejemplos etiquetados, o ni siquiera los necesitan.
Entonces, ¿cuál es la diferencia clave?
El aprendizaje semisupervisado empieza con algo de ayuda.
El autosupervisado aprende por su cuenta desde cero.
En la práctica, el aprendizaje semisupervisado suele ser más fácil de aplicar cuando tienes al menos unos pocos ejemplos con los que trabajar. El autosupervisado, por su parte, suele necesitar conjuntos de datos muy grandes y arquitecturas de modelos más avanzadas.
Ambos métodos son cada vez más populares a medida que la IA sigue evolucionando.
El aprendizaje semisupervisado, explicado
El aprendizaje semisupervisado me recuerda un poco a cómo aprendemos la mayoría.
Con unas cuantas lecciones claras, algo de ensayo y error, y el valor de hacer suposiciones sobre la marcha.
En un mundo inundado de información, no se trata de tenerlo todo resuelto.
Se trata de saber lo suficiente para empezar y estar abierto a aprender por el camino.
Ese es el verdadero poder del aprendizaje semisupervisado.
Y quizá nos recuerde que todos seguimos intentando entender las cosas, paso a paso.
Ahora te toca a ti.
¿Qué estás aprendiendo últimamente, quizá incluso sin tener todas las respuestas desde el principio?
Ya sea una herramienta nueva, un cambio de mentalidad o algo totalmente fuera de tu zona de confort, me encantaría que me lo contaras.
Hasta la próxima,
Helena
Únete a la newsletter
Ideas prácticas sobre IA, liderazgo e innovación. Cada semana.