6 de abril de 2025
Aprendizaje supervisado: enseñar a las máquinas a pensar como nosotros
¿Te acuerdas de cuando aprendías los animales de pequeño?
Tu profe te enseñaba una imagen de un perro y decía: «¡Esto es un perro!». Luego, una vaca: «¡Esto es una vaca!».
Con el tiempo, lo sabías sin más.
Ya no necesitabas al profe para distinguir un perro de una vaca.
Eso es el aprendizaje supervisado en humanos. Aprendemos viendo ejemplos una y otra vez hasta que reconocemos los patrones por nuestra cuenta.
Ahora imagina hacer lo mismo con las máquinas. Les enseñamos a reconocer cosas dándoles ejemplos etiquetados.
Muchos ejemplos.
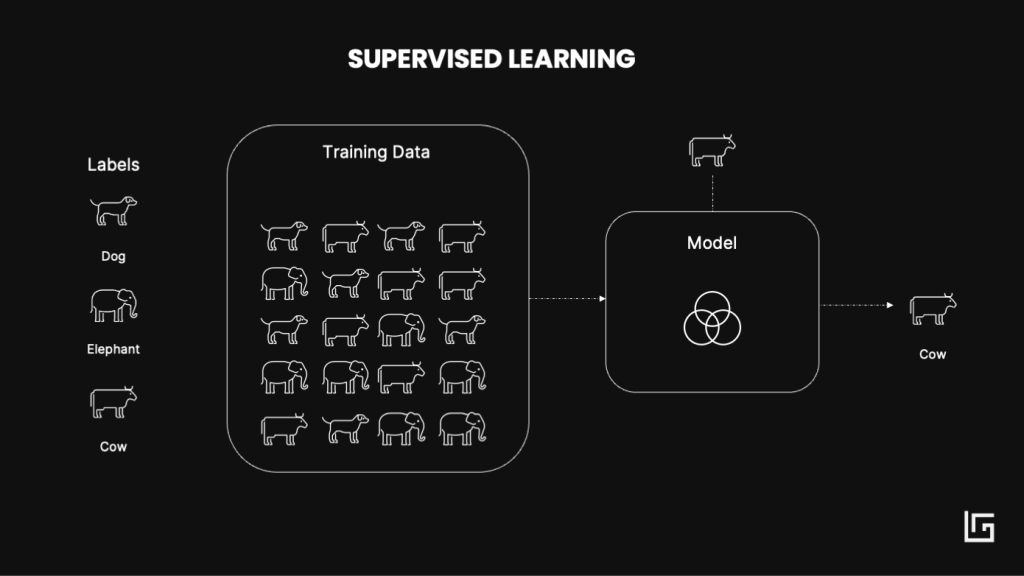
Es como enseñarle a un ordenador mil imágenes de perros, vacas y elefantes hasta que «lo pilla».
¿Qué es el aprendizaje supervisado?
El aprendizaje supervisado es uno de los métodos fundamentales del machine learning. Le das a la máquina datos etiquetados, es decir, ejemplos de los que ya conocemos las respuestas correctas.
Aprende de esos ejemplos y va reconociendo patrones y asociaciones.
Piensa en cómo enseñarías a un niño a reconocer distintos tipos de animales con tarjetas ilustradas, cada una con su etiqueta bien clara.
Con el tiempo, interioriza los rasgos que hacen que un perro sea un perro, una vaca sea una vaca y un elefante sea un elefante.
¿Por qué es importante el aprendizaje supervisado?
El aprendizaje supervisado es el motor de muchas herramientas inteligentes que usamos a diario. Desde los filtros de spam que separan el correo basura de los mensajes de verdad hasta los sistemas de recomendación que saben qué serie querrás ver después. Su fuerza está en la capacidad de hacer predicciones precisas tras entrenarse con datos etiquetados de calidad.
¿Cómo funciona el aprendizaje supervisado?
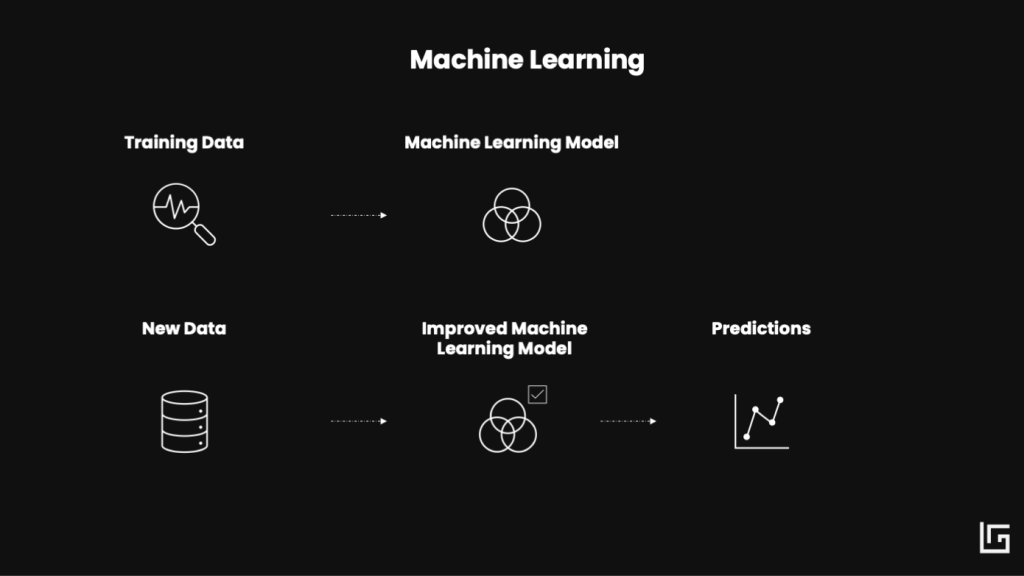
Es un proceso que se repite: entrenar, predecir, comparar y ajustar.
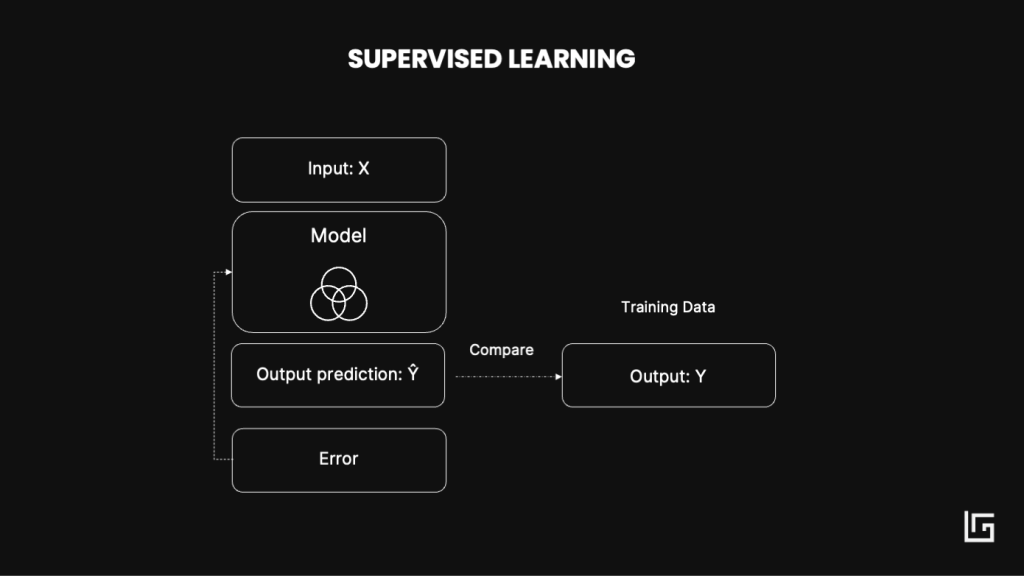
1. Fase de entrenamiento:
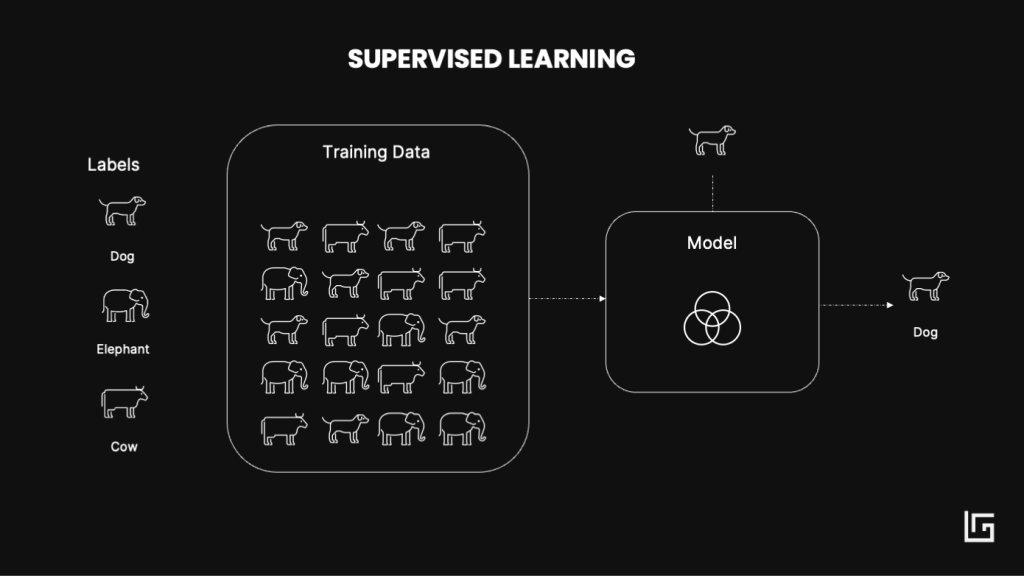
Primero le damos al modelo datos etiquetados, como cuando le enseñamos a un niño tarjetas con animales.
Al principio, la máquina no entiende realmente lo que ve. Procesa cada imagen y detecta sus características: tamaño, forma, textura y otras pistas visuales. Es como enseñarle tarjetas a un niño una y otra vez. Poco a poco, la máquina empieza a asociar los rasgos de cada imagen con la etiqueta correcta.
2. Predicción y comparación:
Cuando el modelo ha practicado con suficientes imágenes, llega el momento de ponerlo a prueba. Le enseñas una imagen nueva de una vaca. El modelo usa lo que ha aprendido e intenta adivinar. «¡Vaca!», anuncia. A veces acierta. A veces se equivoca.
En esencia, el modelo intenta dar una respuesta cuando recibe datos nuevos y nosotros la comparamos con la correcta.
3. Ajuste:
Si el modelo identifica bien la vaca, ¡genial! Va por buen camino. Pero si la confunde con un perro, necesita que se lo indiquemos. Igual que corregirías a un niño con cariño, le enseñas al modelo la respuesta correcta y dejas que ajuste lo que ha aprendido.
Así que, en esta fase, corregimos al modelo si se equivoca y lo afinamos.
Este ciclo se repite hasta que el modelo se vuelve muy bueno haciendo predicciones.
Por qué funciona el aprendizaje supervisado
Cuantos más datos etiquetados tenemos, mejor predice el modelo.
La variedad de los datos también le ayuda a generalizar, para que pueda reconocer una raza de perro que nunca ha visto.
Distintos tipos de algoritmos de aprendizaje supervisado
El aprendizaje supervisado incluye distintos algoritmos, cada uno pensado para tareas concretas. Estos son algunos de los más habituales, junto con recursos para profundizar:
1. Regresión lineal:
La regresión lineal se usa para predecir un valor continuo a partir de unas características de entrada. Representa la relación entre una variable dependiente y una o varias variables independientes ajustando una ecuación lineal a los datos observados.
-> Sigue aprendiendo: Regresión lineal en machine learning | GeeksforGeeks
2. Árboles de decisión:
Los árboles de decisión son algoritmos versátiles que sirven tanto para tareas de clasificación como de regresión. Dividen los datos en ramas según los valores de sus características. Así forman una estructura de árbol en la que cada nodo interno representa una regla de decisión y cada nodo hoja, un resultado.
-> Recurso para aprender: 1.10. Árboles de decisión — Documentación de scikit-learn 1.6.1
3. Máquinas de vectores de soporte (SVM):
Las SVM son algoritmos potentes que se usan sobre todo para clasificar. Buscan el hiperplano que mejor separa los puntos de datos de distintas clases en un espacio de muchas dimensiones, intentando maximizar el margen entre esas clases.
-> Explora las SVM: Máquinas de vectores de soporte para machine learning | Machine Learning Mastery
4. K vecinos más cercanos (KNN):
KNN es un algoritmo sencillo y no paramétrico que se usa para clasificación y regresión. Clasifica un punto de datos según la clase mayoritaria entre sus ‘k’ vecinos más cercanos en el espacio de características.
-> Aprende más: Clasificación con K vecinos más cercanos (KNN) y scikit-learn | DataCamp
5. Redes neuronales:
Inspiradas en el cerebro humano, las redes neuronales están formadas por capas de nodos conectados entre sí (neuronas) que procesan datos. Son especialmente potentes para captar patrones complejos en los datos y se usan mucho en aplicaciones de deep learning.
- Sigue aprendiendo: Deep Learning Specialization | DeepLearning.AI
Ejemplos reales de aprendizaje supervisado
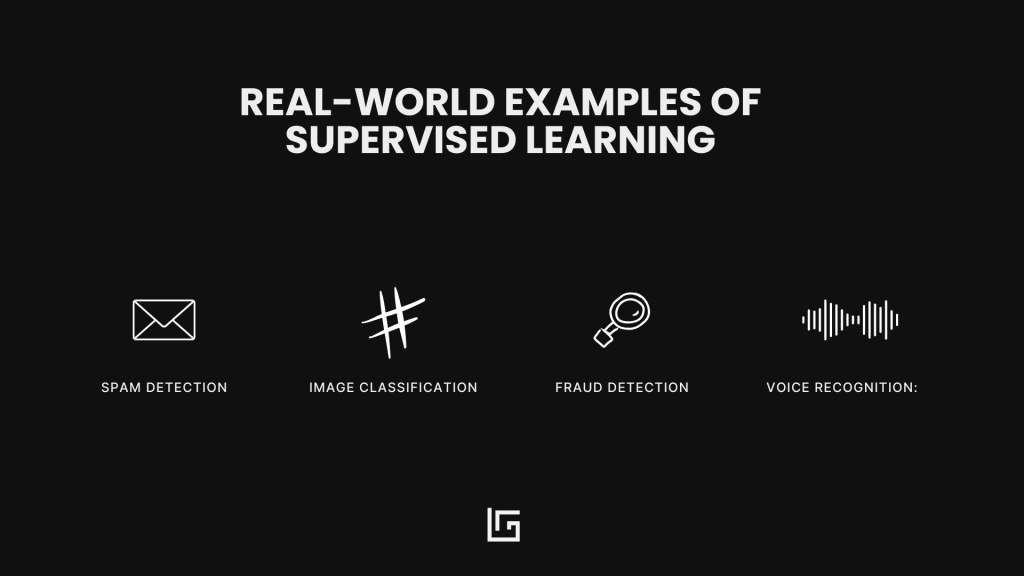
- Detección de spam: Identificar automáticamente el correo basura.
- Clasificación de imágenes: Reconocer gatos, perros e incluso identificar caras.
- Detección de fraude: Detectar patrones poco habituales en las transacciones financieras.
- Reconocimiento de voz: Convertir la voz en texto con precisión.
Retos y limitaciones del aprendizaje supervisado
El aprendizaje supervisado es potente, pero también tiene sus retos. Entender sus límites ayuda a crear modelos más sólidos y a ajustar las expectativas.
1. Calidad y cantidad de los datos:
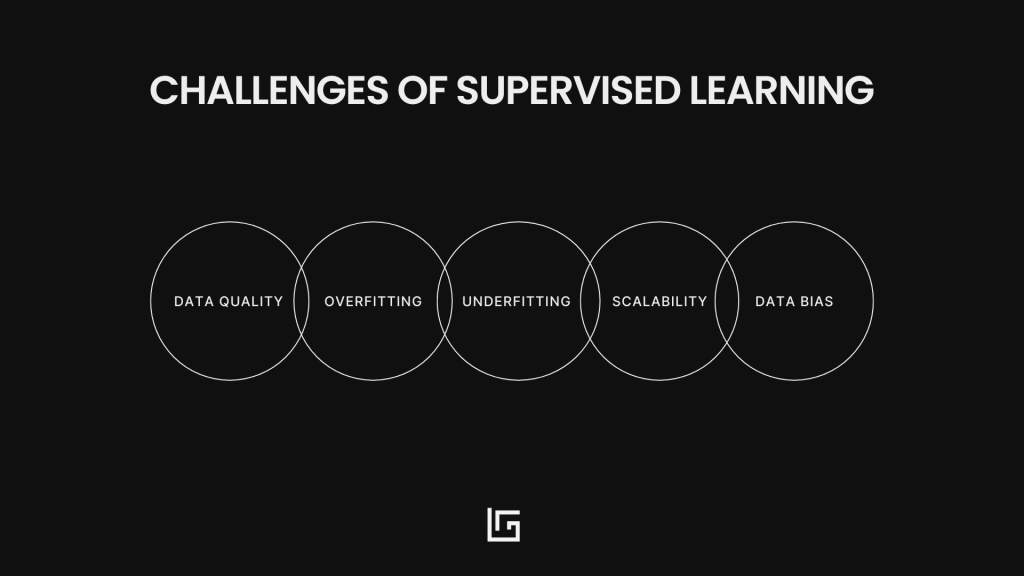
La calidad de un modelo de aprendizaje supervisado depende de los datos con los que se entrena. Si tu conjunto de datos es pequeño, tiene ruido o está mal etiquetado, el modelo rendirá peor. Imagina entrenar un modelo para reconocer perros usando solo imágenes de golden retrievers. Cuando le enseñes un perro salchicha, puede fallar porque no ha visto suficiente variedad.
Solución: Reúne conjuntos de datos grandes y variados, y etiquétalos con cuidado para asegurar su precisión. Las técnicas de aumento de datos, como girar imágenes o añadir ruido, también permiten aumentar la variedad sin necesitar más datos.
2. Sobreajuste:
El sobreajuste ocurre cuando el modelo aprende demasiado bien los datos de entrenamiento: memoriza en lugar de generalizar. Esto puede hacer que rinda mal con datos nuevos. Es como un estudiante que memoriza las respuestas de los exámenes de práctica, pero se atasca con preguntas parecidas en el examen de verdad.
Solución: Técnicas como la validación cruzada y la regularización ayudan a reducir el sobreajuste al evitar que el modelo se vuelva demasiado complejo. Podar los árboles de decisión o usar dropout en las redes neuronales también puede ayudar.
3. Subajuste:
El subajuste es lo contrario del sobreajuste. Ocurre cuando el modelo es demasiado sencillo para captar los patrones que hay detrás de los datos. Es habitual cuando el modelo o algoritmo no es lo bastante sofisticado para la complejidad de esos datos.
Solución: Aumenta la complejidad del modelo, usa algoritmos más avanzados o aporta características adicionales que le ayuden a captar los patrones relevantes.
4. Escalabilidad:
El aprendizaje supervisado puede tener dificultades con conjuntos de datos enormes. Sobre todo con algoritmos como KNN, que necesitan calcular distancias para cada nueva predicción. Entrenar redes neuronales también puede exigir muchos recursos de cálculo.
Solución: Usa técnicas de reducción de dimensionalidad como PCA (análisis de componentes principales) u optimiza los algoritmos para gestionar grandes volúmenes de datos de forma eficiente. Recurrir a plataformas en la nube para entrenar los modelos también puede ayudar.
5. Sesgos en los datos:
Si los datos de entrenamiento contienen sesgos, es probable que el modelo los herede. Por ejemplo, un algoritmo de selección de personal entrenado con datos que favorecen a un grupo demográfico concreto seguirá haciendo recomendaciones de contratación sesgadas.
Solución: Revisa y prepara los datos con cuidado para eliminar sesgos. Incluir métricas de equidad al evaluar el modelo también puede ayudar a detectar posibles sesgos.
Aprendizaje supervisado: máquinas que aprenden como nosotros
El aprendizaje supervisado es una forma de enseñar a las máquinas con ejemplos, muy parecida a cómo aprendemos de niños.
Cuanto más practican, mejor lo hacen.
La próxima vez que desbloquees el móvil con reconocimiento facial o recibas una recomendación de vídeo, sabrás que es el aprendizaje supervisado en acción.
Aprender de los errores: un enfoque humano de la inteligencia de las máquinas
El aprendizaje supervisado refleja nuestra forma humana de adquirir conocimientos. Aprendemos de las correcciones, de estar dispuestos a equivocarnos y aprender de ello. Ver cómo mejora un modelo no es tan distinto de ver cómo se le ilumina la cara a un niño cuando consigue decir bien una palabra difícil.
¿Qué piensas de todo esto? Me encantará leerte.
¡Comparte tus ideas en los comentarios de abajo!
Únete a la newsletter
Ideas prácticas sobre IA, liderazgo e innovación. Cada semana.