23 de agosto de 2026
Regresión en machine learning, explicada de forma sencilla
Ya sabes cómo enseñar a clasificar: le muestras a la máquina ejemplos etiquetados y dejas que aprenda las categorías. Lo expliqué en Clasificación en machine learning.
Pero ¿y si la respuesta no es una categoría?
¿Y si es un número?
Eso es la regresión. Y, sin hacer ruido, está detrás de más decisiones de negocio que cualquier otro tipo de machine learning.
¿Qué es la regresión?
La regresión es machine learning que predice un número.
No «spam o no spam». Ni «gato o perro». Una cantidad: un precio, una demanda, una duración, una puntuación de riesgo.
La clasificación responde a «¿cuál?». La regresión responde a «¿cuánto?».
Ya piensas en términos de regresión
Cuando calculas cuánto cuesta un piso por su tamaño, ubicación y antigüedad, estás haciendo regresión en tu cabeza.
Has visto cientos de anuncios (tus datos de entrenamiento). Has aprendido cuánto importa cada factor (los pesos). Das una cifra (la predicción).
El machine learning hace lo mismo, con un millón de anuncios y sin cansarse.
Los modelos clásicos, en palabras sencillas
Regresión lineal
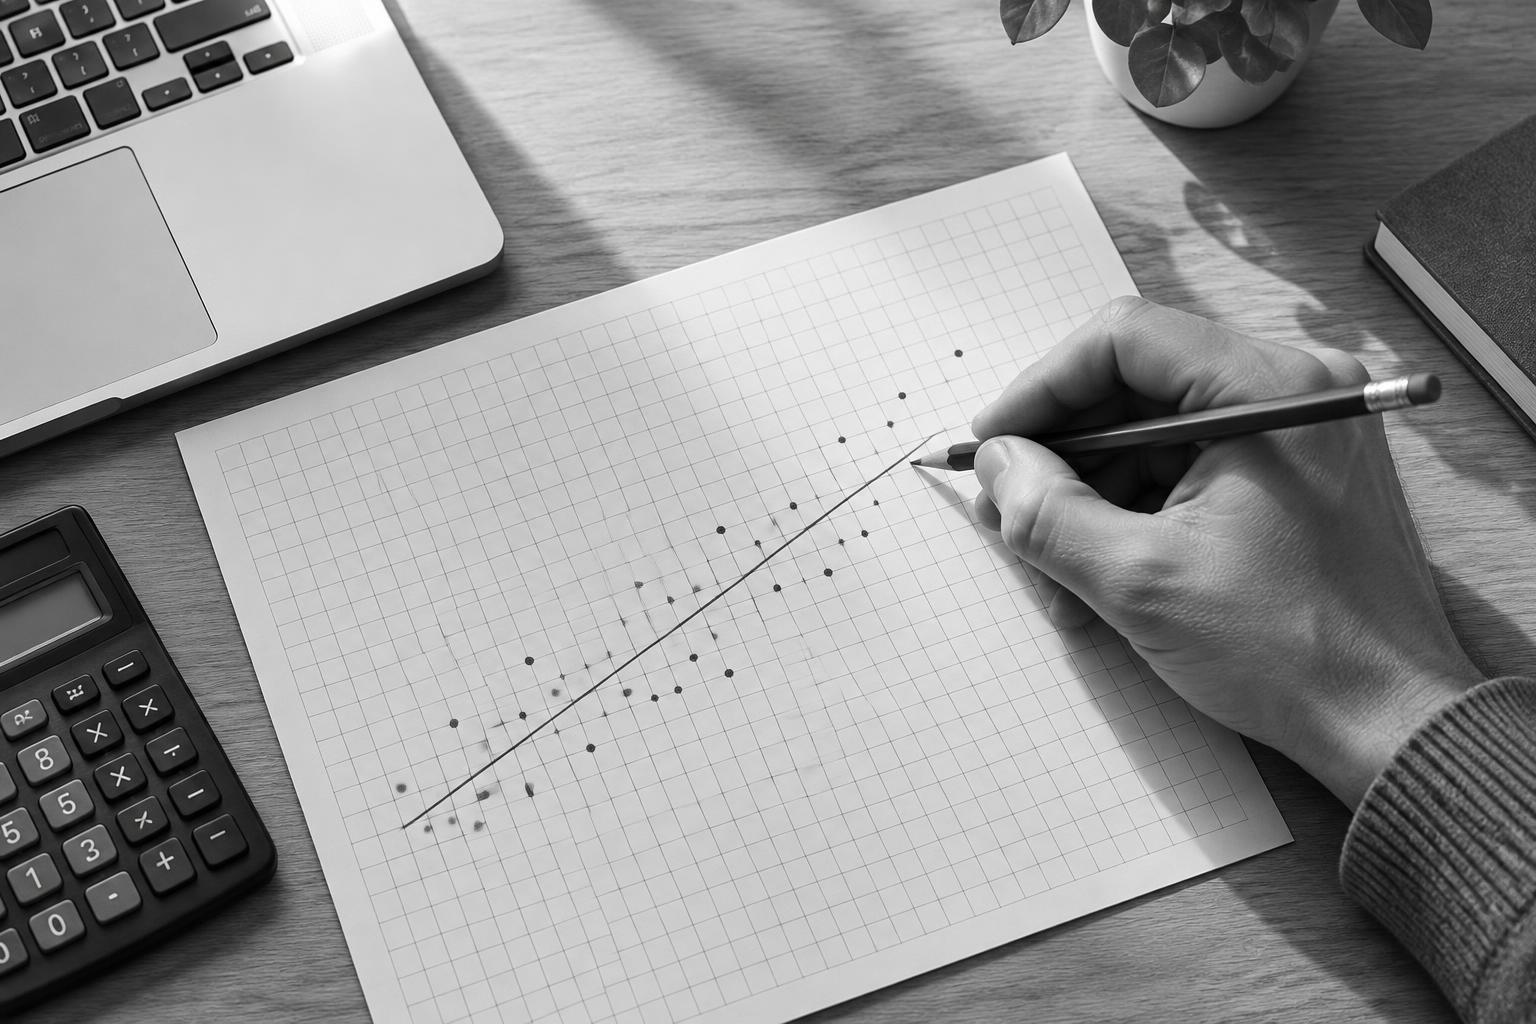
Traza la línea recta que mejor se ajusta a los datos. Sencilla, rápida y sorprendentemente difícil de superar. Cada metro cuadrado de más añade más o menos la misma cantidad al precio. Esa es la suposición «lineal».
Regresión múltiple
La misma idea, con muchos factores a la vez: tamaño, ubicación, planta, año de construcción. El modelo aprende cuánto aporta cada uno.
Más allá de las líneas rectas
La vida real tiene curvas. Los modelos basados en árboles y las redes neuronales captan patrones como «el precio por metro baja en las afueras, pero se dispara en el centro». A cambio, son más difíciles de explicar.
Dónde interviene la regresión en tu negocio
Previsiones de ventas. Estimaciones de plazos de entrega. Demanda de energía. Puntuaciones de riesgo crediticio. Precios de seguros. Gasto en marketing frente a ingresos. «¿Cuántas solicitudes de soporte llegarán el lunes?»
Si la respuesta a la pregunta es un número, alguien, en algún lugar, está usando la regresión para responderla.
Qué puede salir mal (lo que debes saber si lideras)
Correlación no es causalidad. Las ventas de helados predicen los ahogamientos. ¿El motivo? El verano. Un modelo puede predecir bien y aun así llevarte a una conclusión equivocada sobre el porqué.
Si entra basura, sale basura. Un modelo de precios entrenado con datos de 2019 encaja mal con la realidad de 2026. Los modelos envejecen. Volver a entrenarlos es mantenimiento, no un fracaso.
La media oculta los extremos. La regresión busca el mejor resultado para los casos típicos. Pregunta cómo se comporta con los raros: ahí está el riesgo.
Sigue completando el mapa
La regresión y la clasificación son los dos pilares del aprendizaje supervisado. Los otros tipos de aprendizaje —no supervisado y semisupervisado— completan el panorama, y IA, machine learning y deep learning: diferencias te muestra dónde encaja todo.
¿Prefieres aprender haciendo? Mi curso gratuito 10-day AI Crash Course te lleva de cero a manejarte con confianza, con un correo al día.
Únete a la newsletter
Ideas prácticas sobre IA, liderazgo e innovación. Cada semana.