6 de abril de 2025
Modelos de clasificación en machine learning: tipos y ejemplos
Modelos de clasificación en machine learning: lo que todo líder necesita saber
¿Alguna vez te has preguntado cómo reconoce tu cara el móvil o cómo Netflix siempre sabe qué serie te va a encantar?
¡El secreto está en el machine learning!
El machine learning consiste en enseñar a los ordenadores a aprender de los datos.
Igual que las personas aprendemos de nuestros errores y aciertos, el machine learning utiliza datos y algoritmos para crear modelos que mejoran con el tiempo.
Piensa en ello como enseñar a una máquina a reconocer patrones y hacer predicciones.
¿Qué son los modelos de clasificación?
Un modelo de clasificación es un modelo de machine learning que ordena elementos en categorías.
Le das un dato de entrada, como un correo, una foto o una ficha de cliente, y responde a una pregunta: ¿a qué grupo pertenece?
- ¿Este correo es spam o no?
- ¿Esta transacción es fraudulenta o legítima?
- ¿Este cliente se quedará o se irá?
Los modelos de clasificación aprenden de ejemplos etiquetados, así que son un tipo de aprendizaje supervisado. Su hermana es la regresión: la clasificación responde «¿cuál?», y la regresión responde «¿cuánto?».
Tipos de problemas de clasificación
No todas las tareas de clasificación son iguales. Hay tres tipos principales:
- Clasificación binaria: dos respuestas posibles. Spam o no spam. Aprobar o rechazar.
- Clasificación multiclase: más de dos respuestas, pero solo una es correcta. ¿Esta solicitud de asistencia trata sobre facturación, entregas o un problema técnico?
- Clasificación multietiqueta: varias respuestas pueden ser correctas a la vez. Una noticia puede tratar sobre tecnología, política y negocios.
7 modelos de clasificación habituales en machine learning
No necesitas saber programarlos para entenderlos. Aquí tienes la versión sencilla.
1. Regresión logística
A pesar del nombre, es un modelo de clasificación. Calcula la probabilidad de que algo pertenezca a un grupo (por ejemplo, un 82% de probabilidades de que un cliente se dé de baja) y traza una línea entre el «sí» y el «no». Sencillo, rápido y fácil de explicar.
2. Árboles de decisión
Un diagrama de flujo con preguntas de sí o no. «¿El cliente se ha quejado en el último mes? → Sí → ¿Ha reducido su uso? → Sí → Riesgo alto». Muy fácil de interpretar para quienes trabajan en áreas de negocio.
3. Random Forest
Cientos de árboles de decisión que votan juntos. Un árbol puede equivocarse; un bosque es mucho más fiable. Uno de los favoritos para detectar fraudes y puntuar riesgos.
4. Máquinas de vectores de soporte (SVM)
Busca la frontera más clara posible entre dos grupos. Funciona bien cuando tienes muchas características, pero no cantidades enormes de datos, como en la clasificación de textos o imágenes.
5. K vecinos más cercanos (KNN)
«Dime quiénes son tus vecinos y te diré quién eres». Clasifica un elemento nuevo fijándose en los ejemplos más parecidos que ya ha visto.
6. Naive Bayes
Un modelo basado en probabilidades que funciona sorprendentemente bien con textos. El clásico filtro de spam.
7. Redes neuronales
Capas de «neuronas» conectadas que aprenden patrones complejos. Están detrás del reconocimiento facial, del análisis de imágenes médicas y de gran parte de la IA actual. Son potentes, pero necesitan muchos datos y son más difíciles de explicar.
Modelos de clasificación de un vistazo
| Modelo | Ideal para | ¿Es fácil de explicar? | Ejemplo típico |
|---|---|---|---|
| Regresión logística | Decisiones sencillas de sí o no | Sí | Pérdida de clientes |
| Árbol de decisión | Reglas que las personas pueden seguir | Sí | Aprobación de préstamos |
| Random Forest | Gran exactitud con datos de negocio | Dificultad media | Detección de fraudes |
| SVM | Textos e imágenes, conjuntos de datos más pequeños | Dificultad media | Clasificación de documentos |
| KNN | Recomendaciones, similitud | Sí | «Clientes como tú» |
| Naive Bayes | Textos | Sí | Filtrado de spam |
| Redes neuronales | Datos complejos: imágenes, voz, lenguaje | No | Reconocimiento facial |
¿Cómo sabes si un modelo de clasificación es bueno?
La exactitud, por sí sola, puede engañarte. Si solo el 1% de las transacciones son fraudulentas, un modelo que siempre diga «no es fraude» tiene un 99% de aciertos. Y no sirve para nada.
Por eso los equipos de datos también se fijan en:
- Precisión: de todo lo que señaló el modelo, ¿cuánto era realmente correcto?
- Recall: de todos los casos reales, ¿cuántos detectó el modelo?
- Matriz de confusión: una tabla sencilla que muestra dónde acierta el modelo y dónde se confunde.
Como líder, la pregunta clave es: ¿qué error sale más caro? ¿Pasar por alto un fraude o bloquear a un buen cliente? La respuesta determina qué modelo y qué métrica importan más.
Modelos de clasificación en las empresas: ejemplos reales
- Banca: detección de fraudes, puntuación del riesgo crediticio
- Sanidad: detección de enfermedades en radiografías y escáneres
- Marketing: predicción de qué clientes se irán o comprarán
- Atención al cliente: envío automático de solicitudes al equipo adecuado
- RR. HH.: filtrado y clasificación de candidaturas (con cuidado con los sesgos)
- Fabricación: detección de piezas defectuosas en una línea de producción
¿Qué es un modelo de machine learning?
Un modelo de machine learning es, básicamente, un programa inteligente que aprende de los datos y hace predicciones.
Estos modelos se construyen con algoritmos de machine learning.
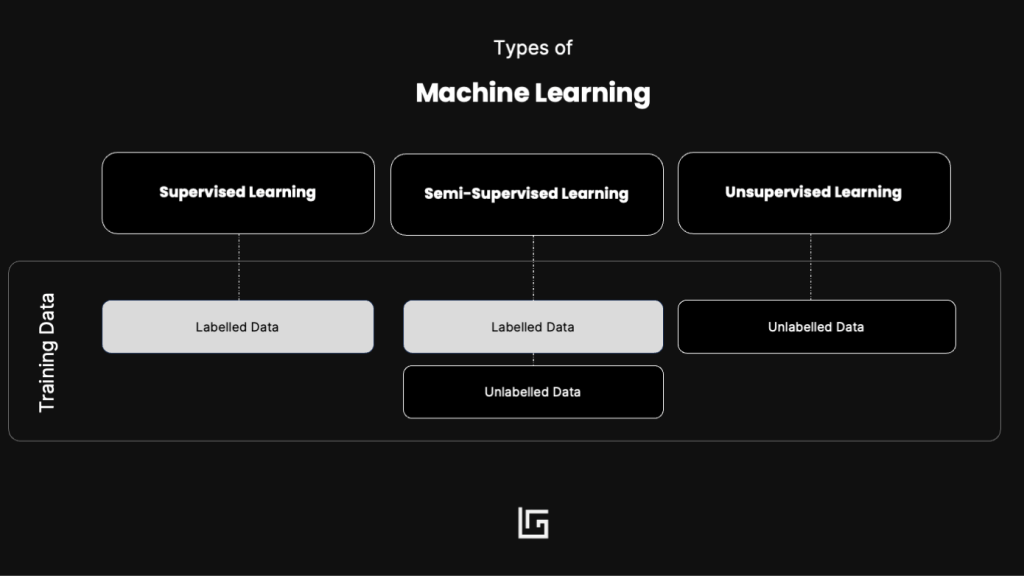
Según los datos que se utilicen, pueden ser:
- Supervisados (datos etiquetados)
- No supervisados (datos sin etiquetar)
- Semisupervisados (una mezcla de ambos)
Algoritmo y modelo: ¿cuál es la diferencia?
A menudo se confunden, pero hay una forma sencilla de entenderlo:
- Algoritmo: la receta que sigues para hacer un bizcocho.
- Modelo: el bizcocho que obtienes después de seguir la receta.
El algoritmo te da los pasos, mientras que el modelo es el resultado final tras entrenarlo con datos.
El machine learning se vuelve más inteligente con el tiempo
Dale más datos a un modelo y mejorará. Ese proceso se llama entrenamiento: así es como los modelos van acertando más con el tiempo.
Pero aquí está la clave: no basta con volcar datos sin más.
A medida que añades más, el modelo pasa por procesos de validación y pruebas.
Este proceso comprueba que funcione bien en el mundo real, no solo con los datos iniciales que le diste para entrenarlo.
¡Este proceso de aprendizaje continuo es lo que hace tan potente al machine learning!
Cuanto más aprende, más inteligente se vuelve.
Puesta en marcha de modelos de machine learning: el proceso paso a paso para crear un modelo
1. Recopila tus datos
Primero, reúne los datos adecuados. ¡Piensa en ellos como tus ingredientes! Ya sean hojas de cálculo, API o archivos CSV, recopila toda la información que necesitarás para entrenar tu modelo.
2. Limpia y prepara los datos
¡Los datos pueden ser un caos! Asegúrate de que sean coherentes: elimina errores, rellena los valores que faltan y usa el mismo formato en todo. Un conjunto de datos limpio te ayuda a empezar con buen pie.
3. Divide los datos
Divide tus datos en conjuntos de entrenamiento y de prueba:
· Conjunto de entrenamiento (70-80%): donde aprende el modelo.
· Conjunto de prueba (20-30%): donde compruebas si de verdad ha aprendido.
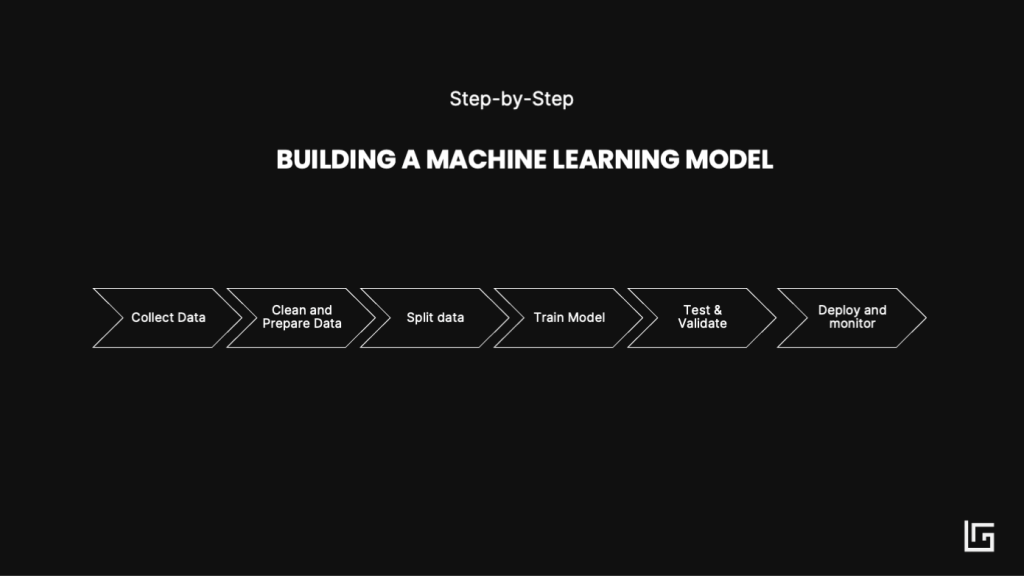
4. Elige y entrena tu modelo
Elige el algoritmo que mejor encaje con tu problema y entrena el modelo con tus datos de entrenamiento. Durante este proceso, el modelo ajusta sus parámetros para aprender patrones y hacer predicciones acertadas.
5. Prueba y valida
¡Ahora toca ver qué tal funciona tu modelo! Usa los datos de prueba para evaluar su rendimiento. Si no es muy bueno, ajusta tu enfoque o vuelve a entrenarlo con más datos.
6. Ponlo en marcha y mantenlo
Cuando estés conforme con tu modelo, ¡toca ponerlo a trabajar! Intégralo en tu aplicación y vigila cómo funciona. Prepárate para actualizarlo a medida que lleguen nuevos datos.
Descubre los tipos de machine learning: supervisado, no supervisado y semisupervisado
El machine learning puede funcionar de distintas formas, pero todo se reduce a una cosa: cómo aprende un modelo de los datos. Vamos a ver los tres tipos principales.
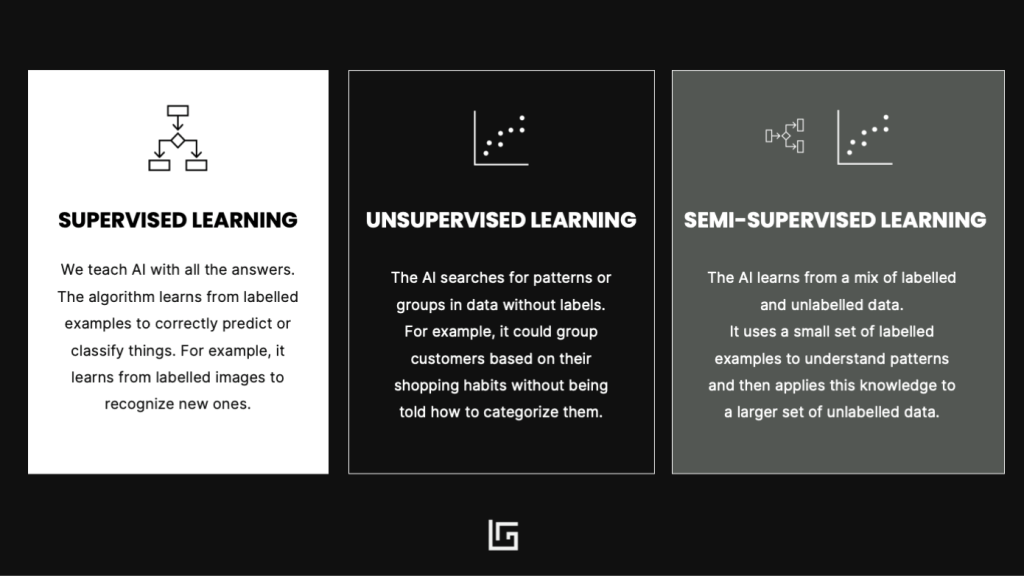
El modelo aprende de datos etiquetados. Se guía por ejemplos, algo parecido a recibir instrucciones directas para hacer una tarea.
Piensa en el aprendizaje supervisado como tener un profesor que le muestra las respuestas correctas.
Los modelos de aprendizaje no supervisado no tienen profesor. Se las apañan solos para encontrar patrones y dar sentido a los datos.
Aquí no hay etiquetas. El modelo explora los datos por su cuenta y encuentra patrones sin ninguna pista.
Es una mezcla de ambos. El modelo recibe algunos datos etiquetados para empezar y los usa para dar sentido a un conjunto mayor de datos sin etiquetar. Es como combinar las dos opciones. Tienes unos pocos datos etiquetados y un montón sin etiquetar. El modelo utiliza la parte etiquetada para dar sentido a los datos sin etiquetar.
Ejemplos de aprendizaje supervisado, no supervisado y semisupervisado
Ahora que ya entiendes los tres tipos principales de machine learning, ¡vamos a verlos con ejemplos concretos! Una cosa es conocer la teoría. Ver cómo funciona en la vida real hace que todo encaje.
Ejemplos de aprendizaje supervisado
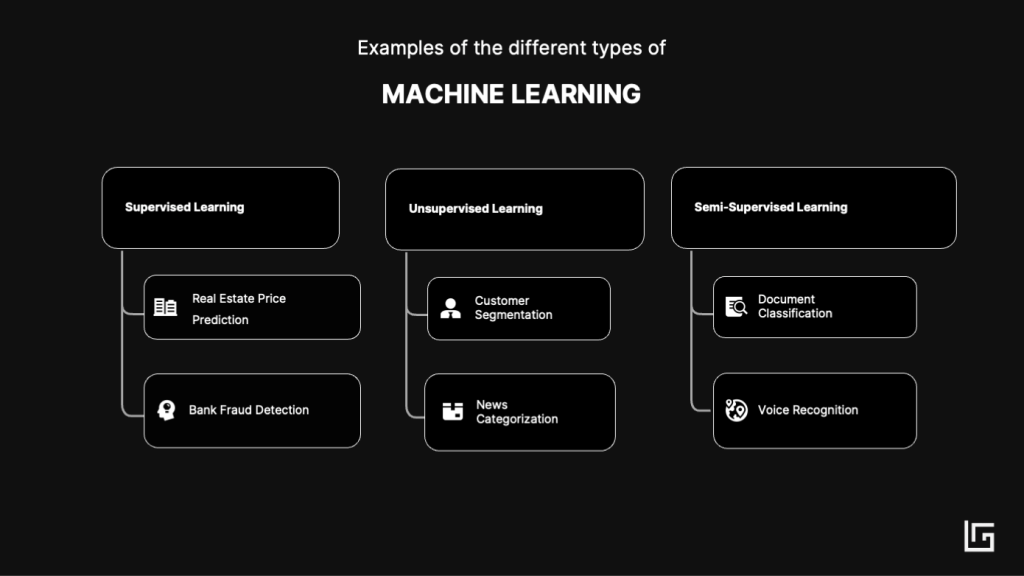
Predicción de precios de viviendas:
Imagina que vas a comprar una casa y quieres saber si el precio es justo. Los modelos entrenados con datos históricos, como la ubicación, el tamaño, la antigüedad y el precio de venta, pueden predecir el valor de inmuebles similares. ¡Muy útil para que inversores y compradores de vivienda tomen mejores decisiones!
Detección de fraudes bancarios:
Piensa en cómo protegen los bancos tu dinero. Usan el aprendizaje supervisado para detectar transacciones sospechosas. Al entrenar modelos con datos etiquetados (fraudulentos o no), pueden detectar señales de alerta en nuevas transacciones y ayudar a proteger a los usuarios de pérdidas económicas.
Ejemplos de aprendizaje no supervisado
Segmentación de clientes:
¿Alguna vez te has preguntado cómo saben las empresas qué tipo de cliente eres? Usan el aprendizaje no supervisado para agrupar a sus clientes según sus comportamientos y preferencias. Eso les ayuda a crear campañas de marketing dirigidas a cada grupo que resultan más personales.
Clasificación de noticias:
Imagina que tienes miles de noticias por organizar. Los algoritmos no supervisados pueden agruparlas automáticamente en categorías, como política, deportes o tecnología, sin necesitar etiquetas. Así los lectores encuentran lo que buscan más fácilmente y los editores mantienen el contenido organizado.
Ejemplos de aprendizaje semisupervisado
Clasificación de documentos:
A veces tienes un montón de documentos, pero solo unos pocos están etiquetados. El aprendizaje semisupervisado utiliza esos pocos ejemplos etiquetados para ayudar a clasificar el resto. ¡Es muy útil para organizar grandes bibliotecas digitales o archivos jurídicos!
Reconocimiento de voz:
Los asistentes de voz usan el aprendizaje semisupervisado para entenderte mejor. Empiezan con muestras de voz etiquetadas y después añaden grandes cantidades de audio sin etiquetar para aprender distintos acentos y pronunciaciones. ¡Por eso tu altavoz inteligente mejora con el tiempo!
Domina el machine learning con el enfoque adecuado
Cada tipo de aprendizaje tiene sus puntos fuertes. Elegir el adecuado depende de tus datos y de lo que quieras conseguir. ¡Conocer la diferencia entre aprendizaje supervisado, no supervisado y semisupervisado te ayuda a elegir la herramienta adecuada para cada tarea!
Preguntas frecuentes: modelos de clasificación
¿Qué es un modelo de clasificación en machine learning?
Un modelo que aprende de ejemplos etiquetados para ordenar datos nuevos en categorías, como spam o no spam.
¿Cuáles son los principales tipos de modelos de clasificación?
Regresión logística, árboles de decisión, random forest, máquinas de vectores de soporte, k vecinos más cercanos, Naive Bayes y redes neuronales.
¿Cuál es la diferencia entre clasificación y regresión?
La clasificación predice una categoría («¿cuál?»). La regresión predice un número («¿cuánto?»). Ambas son formas de aprendizaje supervisado.
¿Cuál es el mejor modelo de clasificación?
No hay un único modelo que sea el mejor. Empieza por algo sencillo (regresión logística o un árbol de decisión). Después, prueba con random forest o redes neuronales si necesitas más exactitud y tienes suficientes datos.
¿Quieres ver dónde encaja la clasificación en el panorama general? Lee IA, machine learning y deep learning: diferencias.
Lecturas relacionadas: La regresión en machine learning, explicada de forma sencilla · Aprendizaje supervisado: enseñar a las máquinas a pensar como nosotros · El aprendizaje semisupervisado, explicado · Guía de aprendizaje no supervisado para principiantes
Únete a la newsletter
Ideas prácticas sobre IA, liderazgo e innovación. Cada semana.