23 de agosto de 2026
Aprendizaje por refuerzo: cómo aprenden las máquinas por ensayo y error
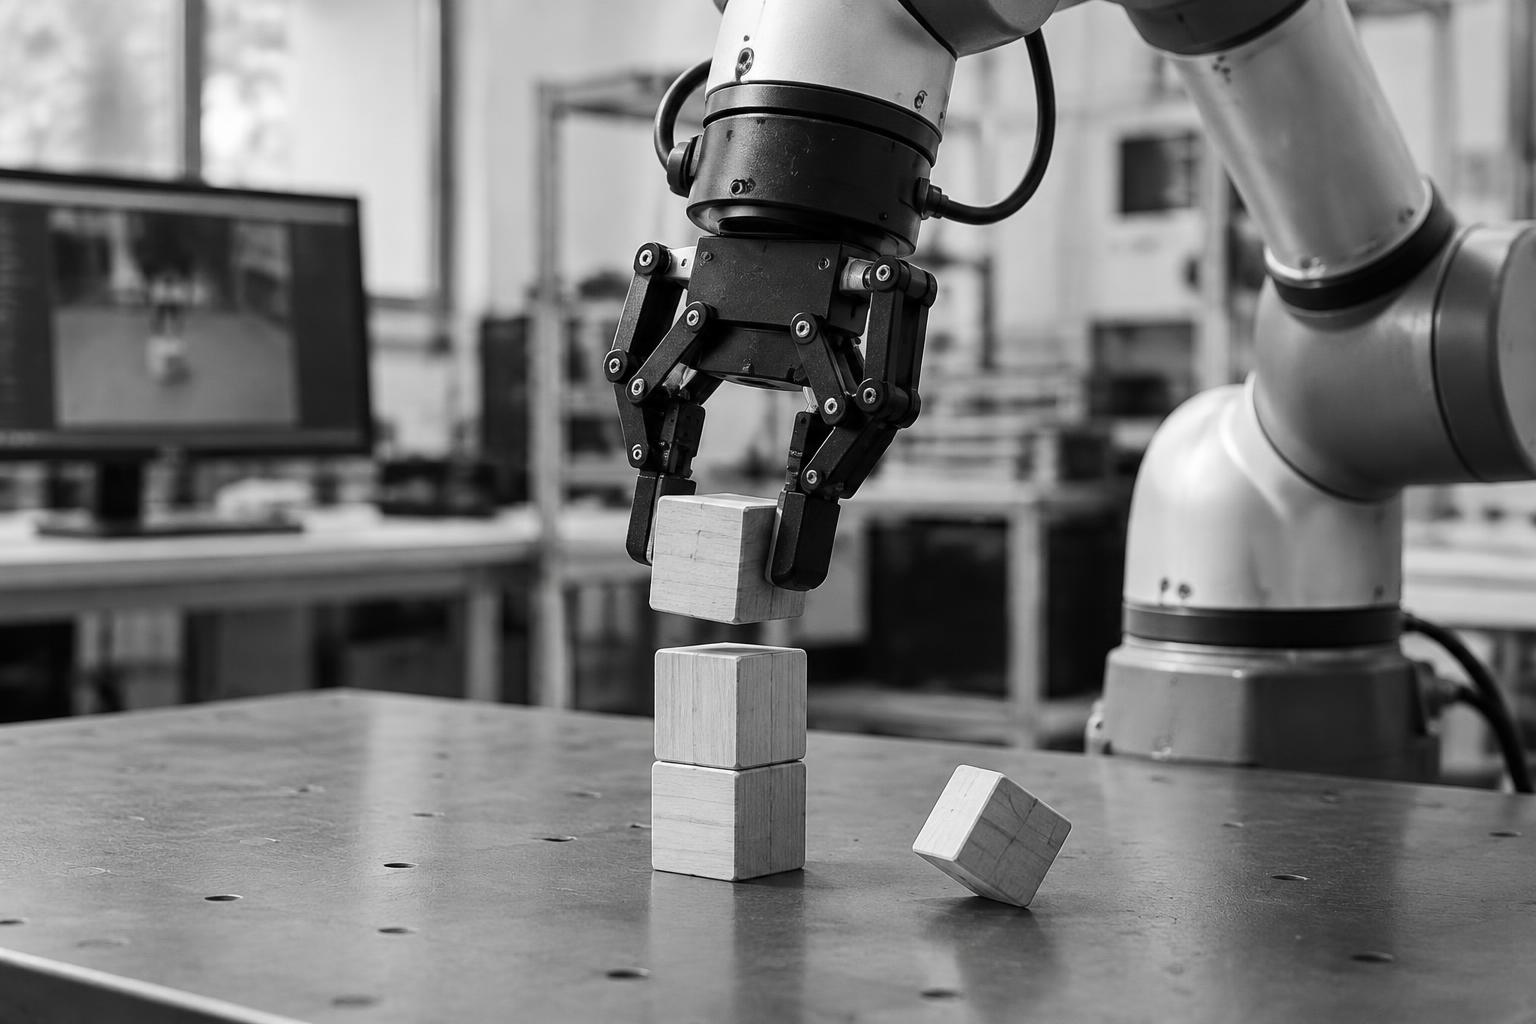
¿Cómo aprendió la IA a ganar a campeones del mundo de Go, controlar robots y, más recientemente, resolver problemas difíciles paso a paso?
No fue con ejemplos etiquetados.
Fue por ensayo y error.
Eso es el aprendizaje por refuerzo, la cuarta forma en que aprenden las máquinas y la más fascinante.
¿Qué es el aprendizaje por refuerzo?
El aprendizaje por refuerzo (RL) consiste en aprender haciendo.
Un agente realiza acciones en un entorno. Los buenos resultados reciben una recompensa. Los malos, no. Tras miles de intentos, el agente descubre qué comportamiento le permite conseguir más recompensa.
Nadie le enseña la respuesta correcta. La encuentra por su cuenta.
Esto ya lo has visto antes
Así aprende un niño a montar en bici. Nadie puede explicar el equilibrio con palabras. Te tambaleas, te caes, corriges y, un día, tu cuerpo ya sabe cómo hacerlo.
También es como has educado a tu perro: premias que se siente e ignoras el caos. El mismo algoritmo.
Las tres piezas que importan
La recompensa
Un único número que define el éxito: puntos conseguidos, energía ahorrada, tarea completada. Si lo defines mal, obtienes exactamente lo que has pedido, que no es lo que querías. (Si premias a un robot por «no caerse», puede aprender a no moverse nunca.)
Exploración frente a explotación
¿Seguir haciendo lo que funciona o probar algo nuevo que podría funcionar mejor? Todos los agentes de RL buscan ese equilibrio. Y todas las empresas también. Es mi metáfora favorita sobre liderazgo, escondida dentro de un algoritmo.
La recompensa que tarda en llegar
La jugada ganadora de una partida puede dar sus frutos veinte movimientos después. Lo más difícil para el RL es atribuir una recompensa tardía a la acción inicial correcta. Algo que también nos cuesta a los humanos.
Dónde aparece el RL en la vida real
IA que juega (la famosa jugada 37 de AlphaGo surgió del RL, no de la imitación). Robots que aprenden a caminar y a agarrar objetos. Refrigeración de centros de datos. Sistemas de recomendación que deciden qué mostrar a continuación.
Y el gran ejemplo: el RL es lo que ha hecho útiles a los chatbots actuales. Tras el preentrenamiento, modelos como ChatGPT y Claude se afinan con aprendizaje por refuerzo a partir de valoraciones humanas (RLHF): las personas valoran las respuestas y esas valoraciones se convierten en recompensas. Los «modelos de razonamiento» actuales van más allá y usan RL para premiar buenas cadenas de pensamiento. También es parte de lo que hace posible la IA agéntica.
El mapa está completo
Ya conoces las cuatro formas en que aprenden las máquinas: aprendizaje supervisado (aprender de etiquetas), no supervisado (encontrar estructura), semisupervisado (un poco de ambos) y por refuerzo (aprender de las consecuencias).
Vuelve a la visión general con IA, machine learning y deep learning: en qué se diferencian, o descubre cómo empezó todo en mi cronología de la IA.
Y si tú también aprendes mejor por ensayo y error (que sí, nos pasa a todos), el 30-Day AI Challenge gratuito te propone un pequeño experimento al día.
Únete a la newsletter
Ideas prácticas sobre IA, liderazgo e innovación. Cada semana.